
丨2026年11月20日星期五丨
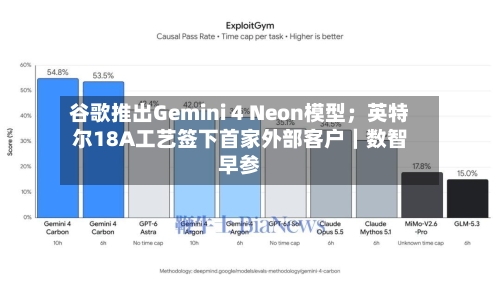
NO.1 谷歌推出Gemini 4 Neon模型
11月19日,谷歌正式推出Gemini 4 Neon。据介绍,企业日常业务高度依赖电子表格、PDF文档、图表及音视频资料。Neon能够在单个100万token上下文窗口内同步处理各类异构数据,并将其整合为结构化交付物。该模型定价为每百万输入token 3美元(缓存输入token享0.5折优惠,仅需0.15美元/百万),每百万输出token 15美元。
点评:当头部能力差距收窄,定价颗粒度、缓存折扣与推理档位细分,正取代跑分成为企业选型的硬指标。对国内厂商而言,压力不只在能力上限,更在于能否把单位任务成本继续打下去。
NO.2 英特尔18A工艺签下首家外部客户
11月19日,英特尔首席执行官陈立武当地时间周三表示,公司已为其18A芯片制造工艺签下首家外部客户。他并未透露客户名称。在经历多年失误和芯片良率偏低的问题后,英特尔一直将18A工艺视为实现业务扭转的关键,希望借此转型为一家能够为外部客户提供有竞争力的芯片制造服务的企业。首席技术官拉纳德随后在社媒上表示,该外部客户签约采用的是英特尔18A-P制造工艺节点,该工艺已于6月进入风险试产阶段。
点评:对长期只能给自己造芯片的英特尔来说,“有人愿意把先进制程交出来”本身就是信用重建的起点。下一个悬念是这位客户究竟是谁——苹果、英伟达,还是被台积电产能卡住的云厂商,答案将决定18A能否真正撑起代工转型。
NO.3 火山引擎上线豆包实时音视频通话模型API服务
11月19日,火山引擎正式上线豆包实时音视频通话模型(SeedRealtime 1.0)API服务,带来全模态交互的新体验。SeedRealtime将声音、画面、时序与表达统一到同一个端到端模型中,能在连续的多模态信息流上实时交互,带来“边看、边听、边说”的全新体验。
点评:把ASR、VLM、TTS三级串联压进一个端到端模型,价值不在“能视频通话”,而在于消掉了级联架构固有的延迟叠加与信息损耗,让模型从“等用户提问”变成“持续看、适时说”。国内大模型的价格战已经打到推理成本,下一轮比拼的将是全模态实时性的工程能力与端侧适配。
(文章来源:每日经济新闻)



